Machine Learning
Super Mario mit Deep Reinforcement Learning
Ein RL-Projekt für Super Mario Bros: alle 32 Level gelöst, das Spiel komplett durchgespielt (Double DQN + PPO), mit Go-Explore, Behavior Cloning und Transfer Learning – und fünf Metriken, die etwas anderes gemessen haben als gemeint.
Worum geht’s
Ein RL-Projekt von Grund auf: Ein Agent lernt die NES-Version von Super Mario Bros zu spielen, nur aus den Pixeln des Spielbildschirms. Niemand sagt ihm, wie man spielt – nur dass rechts gut ist und Sterben schlecht. Drumherum die komplette Technik, damit das Training reproduzierbar läuft und das Ergebnis im Browser zeigbar ist.
Ergebnis: Super Mario Bros komplett durchgespielt – 32 von 32 Leveln
Jedes Level erfüllt dasselbe, vorab definierte Erfolgskriterium: 20 von 20 Greedy-Episoden bis zur Flagge.
- Level 1-1 per selbst implementiertem Double DQN (Online-/Target-Netz, Experience Replay, Epsilon-Greedy)
- Alle übrigen 31 Level per PPO (Stable-Baselines3) – die erarbeitete Standard-Pipeline (VecNormalize, LR-Decay, 16 parallele Envs) löst ein neues Level in ~40 Minuten Training
- Für die Stellen, an denen reines RL scheiterte, je ein eigenes Werkzeug: Go-Explore-Savestate-Suche (Trampolin-Turm 2-1, Labyrinthe 4-4 und 7-4, Welt 8), Behavior Cloning und Transfer Learning zwischen baugleichen Leveln (5-3)
- Alle 32 trainierten Modelle als Releases veröffentlicht (v1.0 bis v1.3)
Ehrliche Einordnung: Die Umgebung ist bei Greedy-Spiel deterministisch. „20/20” heißt zuverlässig reproduzierbar, nicht robust gegen Störungen.
Selbst ausprobieren
Der rote Faden: fünf Metriken, die etwas anderes maßen als gemeint
Das eigentliche Thema des Projekts hat sich erst beim Bauen gezeigt – und lief unter jedem schweren Level mit:
- Loop-Farming (4-4): Falsche Wege werfen Mario zurück, große x-Rücksprünge kosten keinen Reward – also lief der Agent endlos im Kreis: 13.824 Reward bei 0 % Flagge. Fix: ein
ProgressReward-Wrapper, der nur neue x-Maxima belohnt. - 16-Bit-Overflow (4-4): Danach farmte der Agent einen Emulator-Glitch, bei dem
x_posbeim Screen-Übergang kurz auf 65535 springt – 57k Reward für einen Integer-Überlauf. Fix: nur physikalisch plausible Schritte zählen. - Tote Kandidaten (5-3): Diesmal war es nicht der Agent, sondern mein eigener Suchcode. Beim Sturz läuft
x_posweiter hoch, weil Mario im Fall nach vorn fliegt – damit gewann ein tieferer Sturz gegen jeden sicheren Stand, und die Suche meldete „Durchbruch” für einen toten Kandidaten. - Maximum statt Endposition (7-4): Go-Explore bewertete Kandidaten nach dem erreichten Maximum – in einem Loop-Level zählte damit ein Ausflug, der im Rückwurf endete, als Erfolg.
- Ein blindes Messgerät (8-4): In der Loop-Passage zählt
x_posbeim Im-Kreis-Laufen einfach weiter – Reward,ProgressRewardund Go-Explore-Kriterium logen gleichzeitig. Mein Ersatzsignal war genauso blind: Ich suchte 40.000 Kandidaten lang mit dem falschen RAM-Byte ($0760statt$074E).
Alle Fixes wurden vorab am Exploit-Modell gemessen, bevor neue Rechenzeit investiert wurde (13.824 → 1.574 bzw. 64.735 → 221). Gemeinsamer Nenner: Der Agent optimiert exakt das, was gemessen wird – nie das, was gemeint war. Dieselbe Lücke kostet hier ein Level und heißt in echten Systemen Alignment-Problem.
Die lehrreichsten Etappen
- 5-3: Transfer schlägt Suche. Der Agent fror bei exakt x 783 ein – derselben Stelle wie einst 1-3, weil Nintendo beide Baumwipfel-Level aus demselben Baustein gebaut hat. Vier Ansätze scheiterten (6M Steps, Entropie-Boost, 32.000 Go-Explore-Kandidaten, 168 geskriptete Sprungvarianten). Dann durfte das 1-3-Modell einfach 5-3 spielen: x 1606 auf Anhieb, Feintuning, 20/20. In 6-3 wurde derselbe Trick getestet und verworfen – ähnlicher Leveltyp ist kein Zwilling, und der Test kostete zwei Minuten statt Stunden Rechenzeit.
- 7-4, das härteste Level: ein Labyrinth-Schloss mit fünf Gates, gelöst über vier aufeinander aufbauende Suchstufen und einen 762 Schritte langen geklonten Weg. Der Durchbruch kam nicht durch mehr Suche, sondern durch einen Screenshot: Nach 20.000 festhängenden Kandidaten zeigte ein Bild, dass der Savestate direkt an einer Grubenkante lag. Mit 100 px mehr Anlauf fiel die Stelle nach 14 Kandidaten.
- 8-4, das Finale: brauchte eine achte Aktion.
SIMPLE_MOVEMENTkennt kein ↓, ohne ↓ steigt man in keine Röhre – das Level war also prinzipiell unlösbar, egal wie lange trainiert wird. Als Opt-in-Schalter ergänzt, damit die 31 bestehenden Modelle unberührt bleiben. - 8-2, der lehrreichste Widerspruch: Ein Resume-Lauf verbesserte den Trainings-Reward und verschlechterte gleichzeitig die Greedy-Leistung. Beide Zahlen stimmten – der Trainings-Reward mittelt über 16 stochastische Envs, der Greedy-Lauf ist ein einzelner deterministischer Durchgang.
Daraus wurde eine Diagnose-Faustregel: Kurve steigt noch → weitertrainieren; Kurve friert ein → Savestate-Suche; kenne ich ein baugleiches gelöstes Level → erst dessen Policy probieren.
Sichtbar gemacht
- Grad-CAM-Vision-Overlay: macht sichtbar, worauf das CNN pro Aktion „schaut” – inklusive DQN-vs-PPO-Vergleich: zwei Algorithmen, zwei Blickweisen auf dasselbe Level
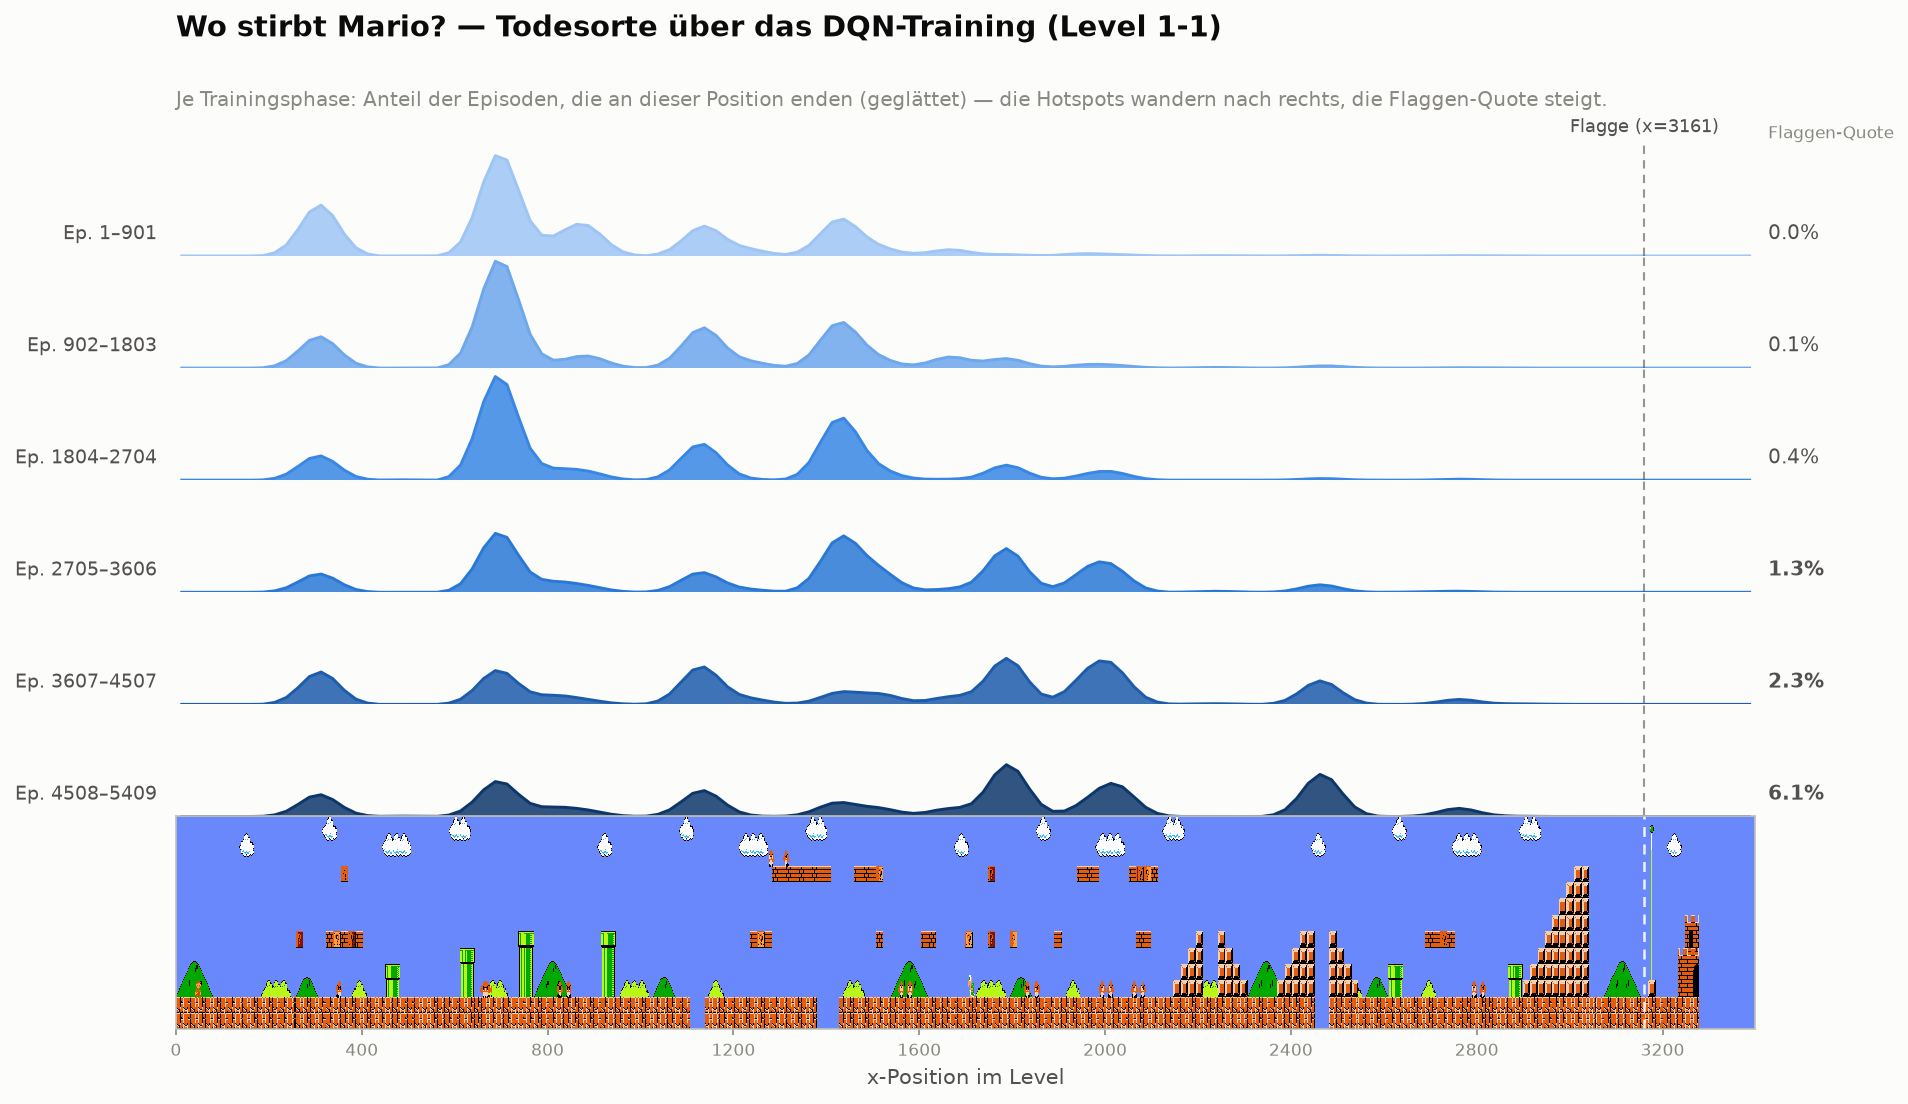
- Death-Heatmaps: Todespositionen aus 5.409 Trainingsepisoden über einem Level-Panorama – man sieht, wie das Level von links nach rechts „erobert” wird
- Wenn der Agent scheitert: drei GIFs der Zwischenstände davor – Reward-Hacking (4-4), Resignation vor einem Gate (7-4), Stehenbleiben aus Sicherheit (8-2). Jeder Fall führte zu einem konkreten Fix im Code.
- Mensch vs. KI: eigenen Lauf aufnehmen und als Side-by-Side-GIF gegen den Agenten antreten, gegen jedes der 32 Level
Das Engineering drumherum
- Tests (pytest) + CI über GitHub Actions (laufen ohne Emulator/GPU)
- Docker + Kubernetes: ein Hyperparameter-Sweep lief real als vier parallele K8s-Jobs in einem kind-Cluster – inklusive der Lektionen dahinter (24-GB-Build-Kontext, OOMKilled durch den Replay-Buffer)
- Optionales Weights & Biases-Experiment-Tracking
- Eine Gradio-Demo-App, deployt als öffentlicher Hugging-Face-Space mit allen 32 Leveln. Der Space zeigt vorberechnete Läufe – auf fremder Hardware divergiert die deterministische Trajektorie, weil andere BLAS-Rundung einen knappen argmax kippen lässt. „Deterministisch gelöst” gilt eben pro Maschine.
Warum dieses Projekt
RL versteht man nur, wenn man Replay Buffer, Target-Netze und Reward-Design einmal selbst baut und debuggt. Jedes Level zeigte eine andere RL-„Krankheit” mit eigenem Gegenmittel: Instabilität → Reward-Normalisierung, vorzeitige Konvergenz → mehr Entropie, Hard Exploration → Savestate-Suche, Reward-Hacking → messbare Reward-Fixes. Die eigentliche Lehre steckt aber in den fünf Metrik-Fehlern: Wenn eine Suche nichts findet, ist die erste Frage nicht „wie suche ich besser?”, sondern „würde ich einen Treffer überhaupt bemerken?”. Dazu der Teil, der ein Experiment in ein echtes Projekt verwandelt: reproduzierbar testen, containerisieren und als Browser-Demo zeigbar machen.